北美人工智能
北美人工智能 - 认证专家
虚拟细胞 重塑AI医药 https://claeanAi.io

注册于 1年前

回答
56
文章
6
关注者
6

电磁弹射火箭跑出1.6马赫,入轨成本降至三分之一靠谱吗?

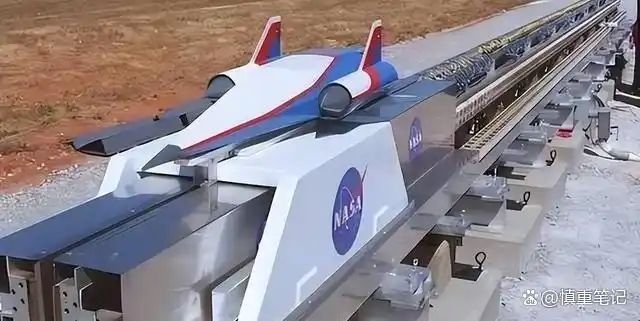
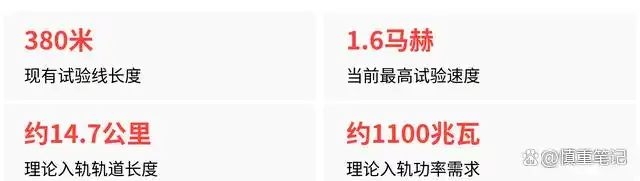
媒体常把两件事放在同一句话里:一枚缩比模型在380米轨道上被推到1.6马赫,和一枚35吨火箭被送进近地轨道。但这两件事的差距,可能不是“放大四十倍”就能描述的。我更想追问的是:大家反复引用的“成本降到三分之一”,到底算的是哪笔账?
aa64034f78f0f7360400f1045bdec00beac41352.jpg
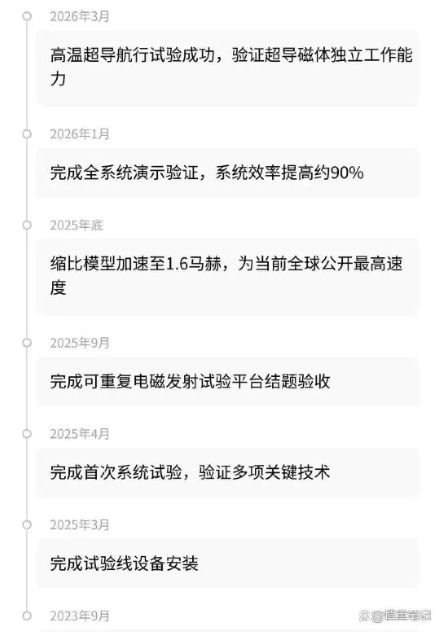
资阳这条试验线,三年里确实在一步步验证关键技术:飞轮储能、电磁推进控制、数字孪生、高温超导航行。2026年初那个“系统效率提高约90%”的说法,我一开始以为是指整条试验线的能量利用效率,后来细看觉得更像某个环节的指标。没有对比基准的效率数字,看看就好。这里有个细节:试验线只有380米,模型是缩比的,速度1.6马赫听起来不低,但离真正替代一级火箭需要的3到4马赫还差一倍多,加速距离则要从380米变成十几公里。
b812c8fcc3cec3fd4c27c5f88703a72d869427bb.jpg
有件反常识的事是:线性放大在图纸上只是乘个倍数,在工程现场却可能变成重新设计。储能系统从百米级需求涨到十几公里级,飞轮、电容、电池的组合不是多加几组就行,热管理、分段供电、实时控制都要跟着重做。资阳验证的“精准供电”模式,在短轨道上能跑到90%的效率提升,放到十几公里轨道上能不能维持,没人说过。这是第一个我没看到答案的问题。
b3fb43166d224f4a0d770fdf597ce3409a22d1a9.jpg
再说那个“三分之一”。它的逻辑基础是省掉一级火箭,听起来成立:地面供电设施可重复使用,箭体不用每次烧掉。但省掉一级火箭不等于只剩下电费。地面上那条高精度轨道、上千兆瓦储能系统、测控和维护体系,是另一笔巨大固定成本。成本能不能摊薄,几乎完全取决于发射频次。分析文章假设一年上百次发射,但没看到任何官方发布过年发射频次规划。万一实际需求一年只有十几次,单次分摊的基建成本可能比火箭硬件还高。这个矛盾,反而被“每公斤500到2000美元”的乐观区间盖住了。

过载问题也被低估了。卫星上的精密元器件要扛住电磁弹射的短时冲击,不是简单加固就行。加固本身会增加重量,可能吃掉一部分“有效载荷提升五成到一倍”的红利。载人标准下轨道长度还要超过20公里,加上应急逃生系统,复杂度再上一个台阶。
历史上: 硅谷如何把“累活”扔给东亚?

20 世纪 80 年代初,英特尔(Intel)并不是什么高高在上的 CPU 霸主,而是一家靠卖存储芯片(DRAM)过活的硬件制造厂。当时日本半导体凭借极度变态的良率控制和企业财阀补贴,将存储芯片价格打掉了 90%。英特尔连亏几个季度,濒临破产。
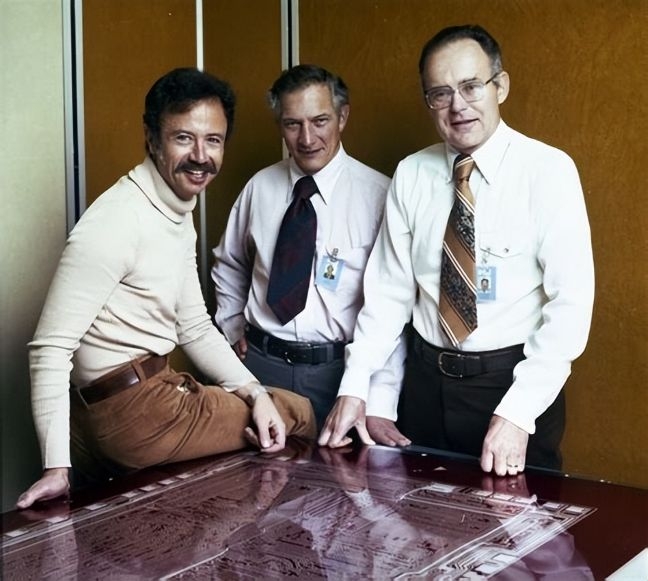
1985 年的一个下午,英特尔 CEO 安迪·格鲁夫(Andy Grove)在办公室里问董事长戈登·摩尔(Gordon Moore):“如果我们被董事会开除了,新 CEO 进来会干什么?”
摩尔叹了口气:“他会带公司放弃存储芯片。”
格鲁夫盯着摩尔:“那为什么我们不自己走出去,再重新走进来做这件事?”
这句话直接改写了全球科技史。英特尔果断关停所有存储芯片工厂,剥离高资本开支、高折旧、极易陷入死循环价格战的物理制造环节,转型做重专利、重架构的微处理器。
25f85264c36f3efa945feb3b5e804f14.jpg
Andy Grove、Robert Noyce、Gordon Moore

这一撤退,直接启发了硅谷巨头们的集体觉醒:放弃物理制造,退守绝对堡垒。
随后,硅谷把动辄烧钱几百亿美元、折旧像烧纸一样的晶圆制造和组装“扔”给了东亚(直接催生了台积电模式与东亚供应链),自己则死死把守住底层指令集架构、操作系统、EDA 软件和底层生态。
这就形成了今天全球科技业最精妙的分工:
美式生态模式(极低边际成本): 软件与架构写完第一份,卖给第 1 个人和卖给第 1 亿个人的成本几乎为零。写一行代码,赚一辈子过路费,毛利率动辄 70%–80%。
东亚物理模式(极高 Capex 与折旧): 机器一开,设备折旧每秒都在吞噬现金流。为了分摊昂贵设备折旧,工厂必须 24 小时满负荷运转,产出越多,市场越饱和,价格战越惨烈。
用当下最火的比喻来说:100 个淘金客在矿山里打得头破血流、把金价卷成白菜价;硅谷则是站在矿山门口卖铲子、收门票的老汉——不管谁淘到金子,都得先给他交 30% 的过路费。

这种“生态收费站”的威力有多恐怖?看两个隐秘却真实的事实就够了。
很多人以为芯片竞争是光刻机的竞争,但很少有人知道,在光刻机动手刻电路之前,全球所有芯片的设计都离不开 EDA(电子设计自动化)软件。
全球 EDA 市场的命脉,几乎被 Synopsys(新思科技)和 Cadence(楷登电子)等几家美国软件公司死死垄断。全球几百万芯片工程师,如果不按月缴纳昂贵的软件订阅费,连一张最基础的芯片电路图都画不出来。

另一个更疯狂的例子,是如今市值冲破天际的英伟达。

英伟达 GPU 那高达 75% 的“印钞机级”毛利率,根本不是靠堆沙子(硅片)堆出来的,而是靠黄仁勋 20 年前的一场疯子般的豪赌。
2006 年,黄仁勋做了一个让华尔街集体炸毛的决定:在英伟达出售的每一块显卡里,强行植入 CUDA 代码架构。这导致显卡成本飙升、功耗大增,而在当时,根本没有所谓的 AI 大模型,市场完全不需要这个功能。
华尔街认为黄仁勋疯了,股价在金融危机期间重挫近 80%。但黄仁勋咬牙坚持,每年把数亿美元利润砸进 CUDA 社区,免费送给全球大学教授和科研人员使用。
这场长达 17 年的“赔本赚吆喝”,最终演变成了科技史上最可怕的“生态锁死”:

全球整整一代 AI 科学家和工程师,从上大学起就是用 CUDA 编写代码的。
今天,哪怕竞争对手造出了物理算力相同的芯片,工程师因为换掉这套“语言字典”的迁移成本高到无法接受,也只能乖乖给英伟达双手奉上巨额溢价。
加上苹果 App Store 每年躺着收割的数十亿美元“苹果税”,硅谷巨头们早已脱离了“造物”的苦海,进化成了收割“赛博地租”的终极食利者。

欧盟 FSD 等待获批
HSf_0XxaYAAQIJa.jpg

下一位大神是谁?

试乘&路测:

  • 🇮🇹意大利
  • 🇫🇷法国
  • 🇩🇪德国
  • 🇫🇮芬兰
  • 🇪🇸西班牙

试乘:

  • 🇭🇺匈牙利
  • 🇨🇿捷克共和国
  • 🇨🇭瑞士

路测:

  • 🇬🇧英国
  • 🇸🇪瑞典

特斯拉纯视觉方案(Tesla Vision)是如何在没有雷达的情况下实现深度感知和障碍物识别的?

特斯拉纯视觉方案(Tesla Vision)摒弃了激光雷达(LiDAR)和毫米波雷达,完全依赖车身多路 RGB 摄像头的 2D 图像输入,通过深度学习算法在三维空间中重建出精确的3D 矢量空间(Vector Space)。
cf231cafc8244a93059d29949e502102.jpg
其实现深度感知与障碍物识别的核心机制可拆解为以下四个关键环节:

一、 跨图像与时间轴的深度线索提取

人眼仅靠两只眼睛就能感知距离,特斯拉神经网络模拟了同样的原理,结合单目深度估计(Monocular Depth Estimation)与多目/跨帧线索:
1 单目先验语义线索: 神经网络通过学习海量数据,掌握了现实世界的物理规律。例如:
相对尺寸与透视关系: 图像中车辆越小,距离越远;近大远小的线条会向消失点汇聚。
遮挡与位置关系: 被遮挡的物体必然在后方;物体底部与地面的接触点位置决定了其纵深。
纹理与对比度: 距离越近,表面细节越清晰,对比度越高。
2 运动视差与跨帧融合(Motion Parallax): 车身在行驶过程中,距离近的物体在图像中移动得快(光流变化大),远处的物体移动得慢。算法结合车速与陀螺仪数据,通过连续多帧图像的位移差计算出物体的精确三维深度。

二、 核心架构:Transformer + BEV(鸟瞰图)变换

特斯拉通过 Transformer 神经网络,把分布在车身四周的多个 2D 摄像头图像,实时拼接并转换到统一的 3D 鸟瞰图(Bird's-Eye-View, BEV)视角中:

8路 2D 摄像头图像 ──> 2D 特征提取 (RegNet/BiFPN) ──> Transformer (跨视角融合) ──> 3D BEV 空间特征

消除视角盲区: 单个摄像头只能看到局部 2D 画面,而 BEV 变换将前后左右所有摄像头的重叠视角融合,自动校准摄像头位置失真,消除重叠区域的冗余,生成以车辆为中心的 3D 坐标空间。
时空特征网络(Spatial-Temporal Queue): 系统会在内存中维护一个“时空队列”,将过去数秒内的空间特征与当前帧结合。即使前车被路边大车临时遮挡,神经网络仍能“记忆”并推算出前车在 3D 空间中的位置与轨迹。

三、 终极识别形态:占用网络(Occupancy Network)

传统的自动驾驶依赖“目标检测”——系统必须先识别出“这是一辆 SUV”或“那是一个行人”,才能判断距离。如果遇到异形卡车、倾倒的树木、遗落的沙袋等未定义物体(Out-of-Vocabulary/Long-tail obstacles),传统系统极易漏检或误判。
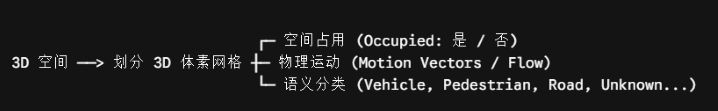
特斯拉引入了占用网络(Occupancy Network),将三维空间切割为无数个微小的三维像素点——体素(Voxels):
f3d2959e60f76743b7558292ad7b405e.jpg

无死角碰撞感知(体素化预测): 系统不再关心“这个物体叫什么”,而是预测“三维空间中的这个体素单元是否被有质量的实体占用”。哪怕是马路上飘着的塑料袋或异形施工车辆,只要被判定为“被占用”,车辆就会提前避让。
占用流预测(Occupancy Flow): 除了预测空间占用,Occupancy Network 还会为每个体素赋予运动向量(Velocity Vectors),计算其未来几秒的运动轨迹与速度,从而精准预测动态障碍物的走向。

四、 训练与超大规模自动标注系统(影子模式)

纯视觉神经网络需要极为海量且精准的“真值(Ground Truth)”数据进行训练。特斯拉依靠以下方式解决了数据难题:
1 自动 3D 离线标注(Auto-Labeling): 特斯拉利用高精度的离线超级计算机,对百万辆运行车辆传回的多帧连续图像、车轮里程计和 GPS 数据进行逆向“3D 神经重建(NeRF/3D Gaussian Splatting)”,生成厘米级密度的 3D 空间真值,无需人工手动标注体素。
2 “伪激光雷达”点云生成(Pseudo-LiDAR): 离线系统通过多帧高精度重建提取出类似激光雷达效果的点云数据(Pseudo-LiDAR),并以此作为标准答案来训练车端运行的实时视觉神经网络。
3 影子模式(Shadow Mode): 算法在车端后台静默运行,将视觉预测的轨迹与人类驾驶员的实际操作进行对比。一旦出现偏差(如人类刹车而算法未识别出障碍物),该段视频就会被自动上传至数据中心用于模型迭代。

总结

特斯拉纯视觉方案之所以能替代雷达,本质上是用海量数据与强大的算力(神经网络)替代了昂贵的硬件传感器:
1 多视角 2D 图像 通过 Transformer 融合成 3D BEV 坐标;
2 占用网络(Occupancy Network) 将 3D 空间体素化,解决非标准障碍物的识别问题;
3 时空队列与单/多目几何预测 实现厘米级的距离与速度感知。

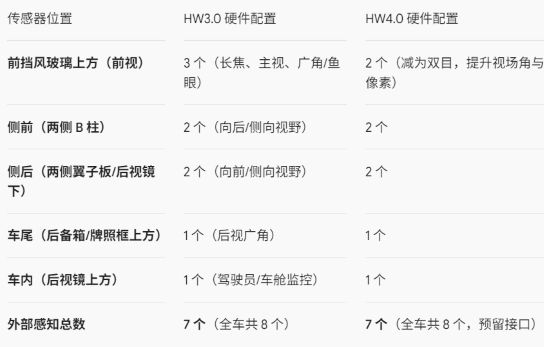
特斯拉车身上的摄像头配置及相关技术参数根据车辆的硬件版本(HW3.0 与 HW4.0)有所区别。以下是具体的规格参数、镜头类型以及透雾性能分析:

一、 车身摄像头数量与布局

特斯拉车身(含车内)通常配备 8~9 个 摄像头:
a589d350b4229ef971890c95652dd75a.jpg

二、 核心规格与参数

1. 传感器分辨率与型号
HW3.0: 采用 120 万像素(1.2 MP,约 1280×960) 的安森美(Onsemi)CMOS 图像传感器。
HW4.0: 全面升级为 500 万像素(5 MP,约 2896×1876) 传感器(普遍认为采用索尼 IMX490 系列技术),解析力提升 4 倍以上,夜视能力和动态范围(HDR)显著增强。
2. 帧率与视场角
HW3.0: 输出帧率为 36 FPS。
HW4.0: 输出帧率降低至 24 FPS,但带来了更宽广的视场角(FOV)和更高的清晰度,有效探测距离提高至约 250–300 米。
3. 镀膜与防眩光(镜头涂层)
镜头表面覆盖有抗反射(AR)镀膜与疏水/防污镀膜。
HW4.0 摄像头的镜头呈现明显的红色/琥珀色偏光镀膜光泽,主要用于过滤特定波长的杂光、增强对比度并提升低照度(夜间)下的色彩还原。

三、 镜头类型与波段

特斯拉使用的是可见光(RGB)车载光学镜头,搭配高动态范围(HDR)CMOS 传感器。
感光波段: 主要覆盖可见光波段(约 380nm - 750nm)以及少量近红外(NIR)补光(主要用于车内监控摄像头)。
非红外/热成像镜头: 外部车身摄像头不属于热红外(LWIR,长波红外)镜头。

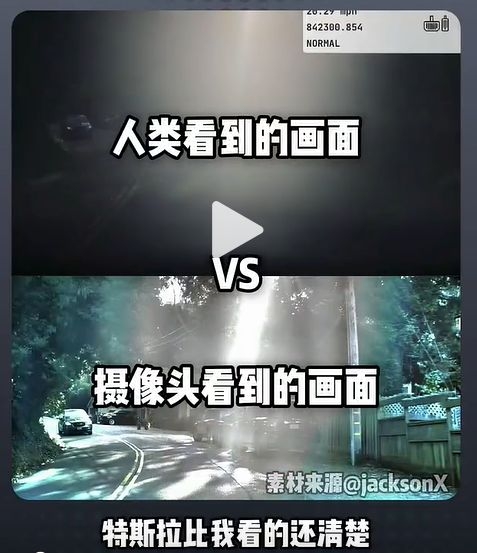
四、 摄像头可以“透雾”吗?

结论:物理上无法穿透中重度浓雾,但通过算法和防雾硬件能够实现“一定程度的抗雾/去雾”。
1. 物理局限(为什么不能透雾)波长限制: 大雾或浓雾由微小水滴组成,水滴会对可见光产生强烈的米氏散射(Mie Scattering)。只有波长较长的长波红外热成像(LWIR)或毫米波雷达/激光雷达才能穿透雾气;而特斯拉的可见光摄像头在浓雾中会受到严重光散射,导致画面变白、对比度急剧下降。
2. 特斯拉的“防雾与抗雾”
应对机制尽管物理透雾能力有限,特斯拉通过以下方式减少雾气影响:
硬件防雾加热(解决玻璃起雾): 前挡风玻璃摄像头舱内集成了加热丝/加热元件(HW4.0 优化了风扇与加热设计),在车内起雾或寒冷天气时自动加热,防止玻璃内部结露起雾。
算法去雾与神经感知(数字去雾): 特斯拉的 Vision 纯视觉神经网络(Occupancy Network / 占用网络)具备图像去雾增强算法,能从微弱的对比度中识别出前方的车道线和障碍物轮廓。
软件降级机制: 一旦遇到强浓雾导致传感器能见度极低,系统会弹出 “摄像头受阻 / 视觉能见度受限” 警告,并自动降低 AP/FSD 辅助驾驶的速度或提示人工接管。

英伟达Vera震撼登场!黄仁勋重新发明PC:Agent就是一切?

6 月 1 日,台北电脑展前夕,GPU 史上最佳带货主播、英伟达创始人黄仁勋举办了一场 GTC Taipei 2026 主题演讲,展示了围绕英伟达的 AI 工厂生态,还发布了 Vera CPU、Vera Rubin、Vera BlueField-4 STX、DSX、RTX Spark 等。

一串名字砸下来,普通人很容易只记住两个字:很强。

如果只看参数,黄仁勋这次台北演讲很像一场典型的 NVIDIA 发布会。但真正值得注意的变化是英伟达正在把 CPU、GPU、网络、存储、散热、Windows PC,甚至安全权限,全部拧进同一个故事里。

这个故事的名字叫「智能体 AI」,最重要的两个新角色是面向数据中心的 Vera CPU,以及面向个人电脑的 RTX Spark(此前网传的 N1X)。

而从 GPU 到 CPU,再到「重新发明个人电脑」,英伟达不只想继续卖 GPU,它还想继续定义 AI 时代里,数据中心和个人电脑到底该长什么样。

英伟达 Vera 炸场:AI 时代的原生 CPU

先看最硬的一块:Vera CPU。

过去几年的 AI 浪潮之中,英伟达的核心一直是 GPU。从 A100、H100 到 Blackwell,AI 产业的焦虑也基本围绕 GPU 展开,谁买得到,谁供得上,谁能把机柜堆起来。但当大模型从聊天机器人走向智能体,问题开始变复杂。

一个 AI 智能体不只是生成一段文字,它要拆任务、查资料、跑代码、调用工具、验证结果,甚至同时维持成千上万个执行环境。

这时候,CPU 又被推回了台前。于是我们也看到了英伟达为 AI 时代设计的 Vera CPU。

英伟达对 Vera 的定义很直接,这是第一颗为 AI 智能体超大规模运行打造的 CPU。它有 88 个自研 Olympus 核心,支持 Spatial Multithreading,LPDDR5X 内存带宽最高 1.2TB/s。放到 Vera Rubin 系统里,它还能通过第二代 NVLink-C2C 和 GPU 以最高 1.8TB/s 的一致性带宽相连。

11112.jpg
参数背后,CPU 不再只是给 GPU 打杂的「房管」。在智能体工作流里,代码执行、数据处理、沙盒环境、任务编排,都会变成算力工厂的关键路径。英伟达说 Vera 相比 x86 CPU 能带来 1.8 倍更快的任务完成速度,之前也强调过 2 倍能效和 50% 性能提升。

AI 工厂的竞争,已经从「每张卡多少钱」变成「每瓦电能产出多少 token」。Vera Rubin 就是这个逻辑的放大版。

老黄还宣布,Vera Rubin 正在进入全面量产,系统由 Vera CPU、Rubin GPU、Groq 3 LPX、BlueField-4 STX 存储和 Spectrum-6 网络等机架组成。官方给出的说法是,相比上一代 Grace Blackwell,Vera Rubin 在规模化 智能体 吞吐上可达 10 倍。

也正因为智能体会持续读写企业数据,英伟达还把存储和安全塞进了同一套叙事里。Vera BlueField-4 STX 的重点不是又一张 DPU,而是把智能体的上下文记忆、文件访问、网络隔离直接放到芯片层面进行处理。

按照英伟给出的数据,Vera BlueField-4 STX 引入 DOCA(英伟达的软件框架)后,能让运行时的威胁检测比现有无智能体方案快最高 1000 倍,并在最高 800Gb/s 的速率下执行网络和文件访问策略。

RTX Spark 将彻底引爆个人 PC 智能体

如果说 Vera 是 AI 工厂里的新地基,RTX Spark 则是这场发布会里离普通人最近的产品。

英伟达和微软把 RTX Spark 定义为面向个人 AI 智能体的 Windows PC 超级芯片。它有 1 petaflop AI 性能,最高 128GB 统一内存,采用 Blackwell RTX GPU、6144 个 CUDA 核心、第五代 Tensor Core 和 FP4 精度,并通过 NVLink-C2C 连接一颗 20 核 Grace CPU。

1114024634b990ab8acc02a2d3.jpg
对了,这颗 SoC 的 Grace CPU 部分由英伟达与联发科合作定制设计。而首款搭载 RTX Spark 的笔记本电脑则是微软的 Surface Laptop Ultra,将于今年晚些时候正式推出,搭载 RTX Spark 的联想、戴尔、惠普、华硕、宏碁笔记本也都在上市的路上。

RTX Spark 的配置听起来不像传统笔记本电脑,更像 DGX Spark 的消费级改造,包括英伟达给出的使用场景也是诸如:

- 本地运行 1200 亿参数大模型和最高 100 万 token 上下文;
- 渲染 90GB 以上 3D 场景;
- 剪辑 12K 4:2:2 视频;
- 生成 4K AI 视频;
- 在 1440p 下以超过 100 帧运行 3A 游戏。

11111.jpg
搭载 RTX Spark 的 Surface Laptop Ultra,图片来源:英伟达

过去两年,AI PC 最大的尴尬是,很多产品只是在传统 PC 上加了一个 NPU,然后告诉用户「这就是 AI PC」。但普通人真正想问的是能不能不用排队、不用付 token 账单、不把私人文件丢进云端,也让 AI 帮我做点实际工作?

RTX Spark 给出的答案明显更激进,要让智能体直接进入 Windows 工作流。英伟达和微软会提供新的 Windows 安全基础架构和英伟达 OpenShell,让智能体在本机运行时有身份、隔离、策略和权限控制。Adobe 也会为 RTX Spark 重构 Photoshop 和 Premiere,号称 AI 与图形性能最高提升 2 倍。

这当然不是说 PC 马上就会从工具变成同事。真正的门槛仍然在软件,智能体能不能稳定调用应用、能不能理解本地文件、出了错谁负责、用户是否愿意把权限交给它,这些都不是 1 petaflop 能单独解决的。

写在最后

在演讲中,老黄展示了一张围绕英伟达构建的 AI 工厂生态图,几乎囊括了 AI 时代全球最有实力的一批公司,其中联想作为唯一一家港股公司,在最近更是交出了一份史上最好财报。

当然,这场台北演讲也不只是 Vera 和 RTX Spark。英伟达还把「AI 工厂」的施工图往前推了一步,发布了 DSX 平台,同时对应到桌面端,又推出了面向企业用户的 DGX Station for Windows。

另一条线则是物理 AI,英伟不仅发布了 Cosmos 3 开放世界基础模型、物理 AI 开源工具和技能、Isaac GR00T 人形机器人参考设计,还扩大了 DRIVE Hyperion robotaxi 生态。

就像老黄说的,(英伟达)口袋里的东西太多了。从晶圆厂、AI 工厂、企业桌面,到医院、机器人和自动驾驶,英伟达都在试图把「智能体」变成下一代计算平台的默认用户,更重要的「节点」则是数据中心和个人 PC。

传统药物研发一直受困于周期漫长、成本高昂和成功率低下的问题。美国药品研究与制造商协会(PhRMA)的数据显示,每款新药平均研发成本达10.1亿美元,周期需10-15年,临床前阶段成功率不足10%。2026年5月20日,谷歌在加州山景城的I/O开发者大会上推出了Gemini for Science,试图用人工智能技术打破这一僵局。该模型面向全球科研人员,核心功能包括实时追踪最新学术论文、将研究目标自动转化为可执行代码、生成基于数据的科学假设,同时探索“模拟人工智能”技术以实现高保真虚拟细胞模拟。

Gemini for Science的核心优势主要体现在三个方面:首先是文献整合能力,它接入了arXiv、PubMed、蛋白质数据库(PDB)等12个主流科研数据库,能实时更新近10年的学术文献;科研人员输入关键词后,模型可在30秒内生成结构化综述,包含核心结论、实验方法和数据支撑。其次是代码生成功能,支持Python、TensorFlow、PyMOL等15种科研工具,据谷歌内部测试,针对分子动力学模拟的代码生成准确率达85%,可减少手动编码时间约70%。第三是假设生成模块,基于基因组、蛋白质组、代谢组等多组学数据,模型能提出3-5个潜在研究方向,例如在类风湿关节炎的自身抗体靶点研究中,已识别出2个未被报道的蛋白相互作用位点。

技术上,Gemini for Science基于万亿级参数的多模态模型搭建,训练数据覆盖全球3000多家科研机构的公开数据集,包括1.2亿条蛋白质结构数据、5000万条单细胞测序数据和200万条药物分子数据。它的“模拟人工智能”技术核心在于提升时空分辨率,目前已能实现纳米级空间分辨率和微秒级时间分辨率的细胞内分子动态模拟,效率比传统工具高出100倍以上。谷歌透露,该技术正应用于非小细胞肺癌转移机制研究,通过模拟肿瘤细胞与免疫细胞的相互作用,识别潜在治疗靶点。

从价值角度而言,Gemini for Science有望重塑药物发现的流程。谷歌目前推进的临床前项目涉及类风湿关节炎和非小细胞肺癌领域,其中针对PD-1抑制剂耐药性的研究已筛选出2个联合治疗靶点,进入了细胞实验阶段。此外,虚拟细胞模拟技术可减少动物实验数量约40%,缩短临床前周期30%以上,降低研发成本15%-20%。不过,这个模型也面临一些挑战:一是数据隐私问题,科研机构对敏感数据的共享意愿不高;二是模型解释性不足,科研人员需要更透明的决策逻辑来验证结果的可靠性。

行业动态上,2026年4月微软联合MIT推出了Azure Drug Discovery平台,整合了GPT-5科研模块,支持药物分子设计和虚拟筛选;OpenAI在同年3月发布了GPT-5 for Research,专注于材料科学与生物医学,但虚拟细胞模拟的进展尚未公开。国内方面,百度在2026年5月发布了文心一言科研版,重点支持中药成分分析和靶点预测,但参数规模(5000亿)和数据覆盖度与Gemini for Science(万亿级)相比还有差距。目前,AI+科研已成为科技巨头竞争的新赛道,后续技术突破将进一步提升科研效率。
来源 钛媒体

2026年5月,黄仁勋在最后一刻被曝登上“空军一号”,与特朗普一同飞往北京,这确实成为了此次特朗普访华团中最具戏剧性的转折点。在此之前,美媒一度广泛报道黄仁勋“并未受邀”或“将缺席”,但特朗普在Truth Social上的亲自证实打破了传闻。

除了黄仁勋,随行的其他核心商业巨头(共约16位)组成了一支“万亿美元级别”的豪华代表团。他们背后的产业与商业利益可以划分为以下四大核心阵营:
8989.jpg

  1. 人工智能与半导体(AI & Chips)

这是本次访华的重头戏。黄仁勋的临时加入,意味着中美在高端芯片禁令与AI算力合作上可能存在某种潜在的“交易”或“破冰”空间。

黄仁勋(英伟达 Jensen Huang): 代表生成式AI算力和显卡市场。他的目标很明确:在中国这个价值500亿美元的市场中寻找出口禁令的缓和点,并防止中国完全倒向国产AI芯片。

克里斯蒂亚诺·阿蒙(高通 Cristiano Amon): 代表智能手机与5G通信。高通绝大部分收入来自中国厂商,他需要维护移动端芯片的稳定供应。

桑杰·梅赫罗特拉(美光 Sanjay Mehrotra): 代表存储芯片。美光曾因安全审查在华受限,他此行意在修复关系并重夺份额。

2 硬核制造与新能源(Tech & Manufacturing)
这些企业深耕中国供应链,是中国“世界工厂”属性的直接受益者和依赖者。

埃隆·马斯克(特斯拉/SpaceX Elon Musk): 代表电动汽车与低轨卫星。马斯克此行不仅是为了特斯拉上海工厂的利益,更有可能涉及FSD(全自动驾驶)在华落地的最后许可,以及在伊朗冲突背景下对能源供应链的关注。

蒂姆·库克(苹果 Tim Cook): 代表消费电子与供应链稳定性。尽管库克即将卸任,但他代表了苹果对中国制造基地以及iPhone在华销售市场的依赖。

凯利·奥特伯格(波音 Kelly Ortberg): 代表民航客机制造。波音渴望重启在中国的大额客机订单(如737 MAX),以应对来自C919的竞争。

3 金融与资本(Finance & Investment)
金融大鳄们通常扮演“中间人”或“利益撮合者”的角色。

苏世民(黑石 Stephen Schwarzman): 代表私募股权与房地产。他与特朗普和中方高层均有深厚私人友谊,常作为中美商业外交的桥梁。

拉里·芬克(贝莱德 Larry Fink): 代表资产管理。他关心中国资本市场的开放,以及在动荡国际局势下美资在中国金融业的准入。

大卫·所罗门(高盛 David Solomon)及 简·弗雷泽(花旗 Jane Fraser): 代表全球银行业。关注跨境融资、人民币国际化以及美国企业在华的金融服务便利化。

4 工业、能源与农业(Energy & Agri)
由于伊朗战局推高了油价,能源安全是此行的隐性核心。

拉里·库尔普(通用电气航太 GE Aerospace): 代表航空动力与高端制造。

布莱恩·赛克斯(嘉吉 Brian Sikes): 代表农产品贸易。农业作为中美贸易的传统“压舱石”,嘉吉代表了美国农民对中国这一全球最大大豆和玉米进口国的诉求。

总结
这16位巨头的组合传递了一个强烈的信号:特朗普政府试图在技术遏制(AI芯片)与经贸套现(波音订单、中国投资美国)之间寻找一个平衡点。

正如特朗普在社交平台上所言,他希望中方能“进一步开放”,让这些“天才”施展魔力。而黄仁勋的“末班车”入座,更像是为这出大戏补上了最关键的一块拼图——AI时代的利益再分配。

640.jpg
中国市政运作的钱从哪里来、靠什么维持运转?

简单说一句结论:
西方城市主要靠“持有型税收(房地产税)”,而中国城市主要靠“开发型收入 + 转移支付 + 间接税”来运行。

一、西方城市:靠“长期持有税”养城市

你说得没错,很多西方国家(美国、加拿大、英国等):
房地产税(Property Tax)是地方政府的核心收入
按房产价值,每年持续缴纳
用来支付:
市政服务(道路、消防、警察)
公立学校
公共交通、维护费用
👉 特点是:
稳定、长期、和城市规模正相关
房子越多、越贵,城市财政越稳。
640.jpg

二、中国没有房地产税,那钱从哪来?

中国城市运行,主要靠 四大来源(重要性大致从高到低):
1️⃣ 土地出让金(最关键)
这是中国最特殊、也最重要的一项。

什么是土地出让金?

土地归国家 / 集体所有
地方政府把 土地使用权(通常70年住宅)卖给开发商
开发商一次性付钱

为什么它重要?

很多城市 30%–60%的财政相关收入来自土地
用途包括:
修路、地铁
城市扩张
还地方债
补贴公共服务
👉 可以理解为:
中国是“卖地一次性收钱”,而西方是“每年收房产税”。
2️⃣ 税收分成(增值税、企业税等)
虽然房地产税没有,但中国有大量 生产和交易税:
增值税(最大头)
企业所得税
个人所得税(地方分成)
消费税(部分)
特点是:
税由中央和地方 分税制分成
地方政府 非常依赖经济活动本身
👉 所以你会看到:
地方政府热衷招商引资
拼工业园、拼企业、拼GDP
3️⃣ 中央财政转移支付
很多城市(尤其是中西部)自己不赚钱,怎么办?

中央把钱转给地方
用于:
基本公共服务
教育、医疗
维持财政平衡
👉 这是一种 “全国统一兜底”机制,西方国家反而没这么强。
4️⃣ 城投、地方融资(隐性)
严格说这不是“税”,但现实中很重要:
地方成立城投公司
抵押土地或未来收入融资
用于基础设施建设
⚠️ 问题是:
这是 提前花未来的钱
土地卖不动时,风险就暴露出来

三、中西模式的根本差异

bc4118b9ceba6239214f10ba0361cc49.jpg

一句话总结:

中国城市是“靠建设和增长来养自己”,西方城市是“靠既有财富来维持运行”。

四、那为什么中国以前能跑得这么快?

因为在高速城镇化阶段:
人口进城
房地产需求巨大
土地能不断卖
基建拉动经济
👉 这套模式 在“扩张期”非常有效。
但当:
人口增速放缓
房地产降温
土地收入下降
👉 城市财政压力就会显现,这也是现在大家讨论“财政转型”“房地产税”的背景。

五、未来可能怎么变?(简要)

趋势不是“马上照抄西方”,而是:
降低对卖地的依赖
增强稳定税源(服务业、消费、财产性收入)
更强调存量城市、而不是无限扩张
33f4d40791a46d8dba3fca9aa073a82b.jpg

西方国家几乎不可能像中国那样“摆脱房地产税”,如果强行免除,城市财政和社会结构会出现系统性问题。

原因不是“不愿意”,而是做不到、承受不起、也不一定更公平。

一、为什么中国能“不靠房地产税”?

先澄清一个容易误解的点:
中国并不是不从房地产中拿钱,而是“换一种方式拿”。
中国的替代机制
一次性土地出让金
房地产相关税费(契税、增值税、土地增值税)
房企融资 → 地方财政 → 基建回流
👉 对居民来说:
不交“每年房产税”
但在买房时一次性交了很多“隐性税”
本质是:

把“长期税”前置成“高房价”
中国之所以能这样做,依赖三个前提:
土地国有
城市长期扩张
人口和需求持续增长(至少在过去)

二、西方国家为什么不能照抄中国模式?

关键结论一句话:

西方国家缺乏中国那套“可替代房地产税的财政工具”。

1️⃣ 土地制度不同:这是“根本限制”

中国
土地归国家
政府是“唯一卖家”
可以把未来70年的收益一次性收走

西方
土地私有
政府不能卖土地给自己公民
只能对既有财产征税
👉 所以:

没有房地产税,西方地方政府几乎“无合法财源”。

2️⃣ 财政结构不同:地方政府高度依赖房产税
在很多西方国家(尤其美国):
房产税 = 地方财政的命根子

用于:
公立学校
警察、消防
城市维护
如果取消房产税,会发生什么?
只有三种选择:
大幅削减公共服务(学校、治安下降)
提高其他税(所得税、消费税)
中央接管地方财政(这在政治上极难)
👉 换句话说:

不交房产税 ≠ 不交税,而是“换地方交,甚至交更多”。

3️⃣ 政治结构不同:西方很难“集中替代”
中国能做到:
中央协调
地方执行
跨地区财政调剂
而西方(尤其联邦制国家):
地方自治极强
纳税人对税种极度敏感
改税制 ≈ 改宪法级难度
👉 房产税虽然讨厌,但它透明、稳定、可预测,反而是政治妥协的结果。

三、那“免除人们负担”这个目标,真的能实现吗?

这里有个反直觉的结论:

房地产税并不一定比中国模式“更重”,只是“更显眼”。

对比一下负担方式
76fb8553f7362f318b6bb8f3c73b617d.jpg
在西方:
不买房的人 几乎不承担房产税
房子越大、地段越好,税越高
在中国:

房价本身已经把“税”内化
年轻人和首次购房者承担更重

👉 从分配公平角度看:

房产税反而更“按能力付费”。

四、西方如果“真想减轻负担”,能怎么做?

现实中,他们做的是“改良”,而不是“取消”:
常见做法
自住房减免
老年人冻结税额
设置税率上限
低收入补贴
目标是:

保留财政稳定性,同时缓解个体压力
而不是彻底废除。

五、终极结论(核心逻辑)

中国模式是“发展期财政”,西方模式是“成熟期财政”。

中国:
用增长、土地和未来收入,换取现在的城市建设
西方:
用存量财富,维持稳定运转
如果西方学中国:
没有土地可卖
没有高速增长
没有集中财政权力
👉 结果只会是:
财政崩溃 or 税负转嫁,而不是“轻松免负担”。

一句话:

房地产税在西方不是“能不能取消”的问题,而是“取消就没地方政府”的问题。

在西方国家生存,每年讨厌的房地产税,看来逃不过去了。或许,还是在中国拥有房地产生存更加轻松?

记忆可能根本不在大脑里?一位记忆冠军的体验与脑科学的未解之谜

“有人说,记忆可能根本不存储在大脑里。”
这是一个听起来有些荒谬的观点,但在记忆竞技和脑科学的边缘地带,这却是一个引人深思的话题。全美记忆冠军 Nelson Dellis 在一次访谈中,结合自己突破人体极限的亲身经历,对此进行了深入的探讨。我们的大脑究竟是一个存储数据的硬盘,还是一个接收信号的天线?
以下是这次深度对话的核心记录。

突破30秒屏障:一种“无意识”的心流

故事要从2009年说起,当时 Nelson Dellis 刚开始接触记忆训练。多年来,他一直试图将记忆一副扑克牌的时间缩短到极致。
对于当时的记忆选手来说,“30秒”就像是一道不可逾越的墙。Nelson 每天都在练习,但成绩总是卡在30.84秒、30.12秒,始终无法突破。
直到2012年的圣诞节,突破发生了。他在那次练习中跑出了29.74秒的成绩。但让他印象最深刻的不是数字,而是那个过程中的感觉。
“那是一种非常奇怪的体验,”Nelson 回忆道,“在快速翻牌记忆的过程中,我感觉大脑有一部分在说:‘我现在并没有主动在做任何事’。感觉完全不是我在记忆,而是一种直接从记忆中流淌出来的‘心流状态’(Flow State)。”
当计时结束,他发现自己记住了所有内容。那是他第一次感觉自己并没有参与记忆的过程,仿佛记忆是从“别的地方”来的。这种体验让他联想到“体外体验”——你的心智在高速运转,但你却仿佛置身事外。

大脑是硬盘,还是电视机?

这种神秘的体验,结合他后来接触的远程观测(Remote Viewing)训练,让 Nelson 产生了一个大胆的猜想:
“我相当确信,并非所有的记忆都来自大脑内部。我认为大脑只是一个接收器。”
他认为,也许在大脑之外存在某种“基质”(substrate),那里储存着信息,而我们的大脑就像一个天线,负责从那个巨大的云端接入或断开信号。
对话中,主持人提到了英国生物学家鲁伯特·谢德瑞克(Rupert Sheldrake)的类似观点:大脑不像计算机的硬盘,而更像电视机。当你在看电视时,节目画面并不存储在电视屏幕里,而是通过信号流式传输过来的。
当然,这里有一个明显的逻辑反驳:如果记忆是流式传输的,为什么普通人不能直接“接入”贝多芬的频道,瞬间学会弹钢琴?
对此Nelson提供了一种可能的视角:哪怕信号就在那里,你也需要通过练习来“调频”。那位练习了一辈子的钢琴家,通过无数小时的努力,在大脑中建立了正确的通道,从而能够流畅地接收和表达这些信息。

“形态共振”与集体潜意识

如果把这个理论放大,还能解释一些奇怪的历史现象。
主持人提到了著名的“4分钟一英里”效应。历史上,人类曾认为跑进4分钟一英里是不可能的。但当第一个人打破这个纪录后,没过几个月,世界各地的人就陆续打破了它。
谢德瑞克将此称为“形态共振”(Morphic Resonance)。似乎当某个问题在世界的一端被解决,意识的共振让这个问题在其他地方也变得容易解决。这甚至可以与“模拟理论”联系起来:就像电子游戏,一个物体被渲染过一次后,系统在其他地方再次渲染它就会节省算力。
Nelson 证实,这在记忆竞技界真实存在。当30秒记牌的障碍被打破后,就像多米诺骨牌一样,所有人开始突破30秒。现在的世界纪录甚至已经推进到了15秒、10秒的大关。

科学的边界:寻找记忆的物理位置

抛开理论猜想,主流科学界究竟有没有找到记忆的存储位置?
对话中提到了Joshua Foer的书(《与爱因斯坦月球漫步》)以及相关的科学实验:
切除实验:科学家曾尝试切除老鼠大脑的不同部分,试图抹去记忆。结果发现,无论切除哪里,长期记忆似乎从未完全消失。记忆似乎像全息图一样,分布在整个大脑中。
H.M.的案例:1953年,著名的癫痫患者H.M.接受了双侧内侧颞叶切除术(包括海马体)。手术后,他的癫痫治愈了,但他永远失去了形成新记忆的能力(短期记忆无法转化为长期记忆),但他手术前的老记忆却完好无损。
天才的副作用:对话中还提到了丹尼尔·泰米特(Daniel Tammet)。他因童年的一次癫痫发作,大脑结构似乎发生了某种改变,从此拥有了将数字可视化(联觉)的能力,能背诵圆周率后几千位。

结论:没有单一的“硬盘”

在对话的最后,他们通过AI搜索确认了目前的科学共识:并没有一个单一的结论指出记忆具体存储在大脑的哪一个点。
现代神经科学认为,记忆不是固定在某个神经元里的文件,而是一个涉及多个脑区的动态过程,是无数神经元连接之间复杂的物理变化。
看着fMRI扫描图中记忆高手那被完全点亮的大脑,Nelson 承认,虽然我们知道大脑高度参与了记忆过程,但这可能并不是故事的全部。无论是作为复杂的生化机器,还是连接宇宙的接收器,我们对大脑真正潜能的探索,或许才刚刚瞥见冰山一角。

在“人工智能”一词首字母缩写的互联网域名“AI.com”以7000万美元的天价转手后,在2月8日美国超级碗比赛期间,收购人投放了该域名的广告,正式推出“AI代理”业务。
640.jpg
▲1993年以100美元买下“AI.com”域名的阿尔斯扬·伊斯梅尔
此前AI.com的域名就因会选择性地跳转至ChatGPT、谷歌Gemini等AI网站引发关注。去年DeepSeek热潮席卷全球后,该域名也曾设置跳转至DeepSeek官网。马尔扎莱克回应称:“去年我得到收购这个域名的机会,我想如果长期来看,比如10到20年,人工智能将会成为我们这一代人最伟大的技术浪潮之一,所以这会是一次很好的投资。”

在今年超级碗广告播放后,AI.com的访问量激增导致网站一度崩溃。电视广告测量公司EDO表示,AI.com的广告是整个超级碗期间互动性最高的广告,其互动率是今年平均水平的9.1倍。

未来该网站的主要业务是为用户生成私密的个人AI代理,它不仅可以回答问题,还可以代表用户实际操作,包括组织工作、发送消息、在应用程序中执行操作、构建项目等。用户还可以创建专属的域名“AI.com/username”,这一过程中需要输入信用卡信息,主要是为了验证用户是真人才能获得用户名。

一、 突如其来的“转向”
一直以来,马斯克的SpaceX就像是一台为火星量身定制的永动机。他的口头禅是“多行星物种”,目标是那颗红色的行星。

但最近,风向变了。马斯克在多次内部演讲和社交媒体互动中,频率极高地提到了“月球基地 Alpha”(Moon Base Alpha)。根据最新的战略调整信号,SpaceX的工作重心正在向月球倾斜,并提出了一个激进的时间表:10年内建立月球城市。

这不禁让人疑惑:火星不去了吗?

二、 为什么是月球?
马斯克并非放弃了火星,而是意识到:直接跳到火星,步子迈得太大了。

阿耳忒弥斯计划(Artemis)的推力 NASA的重返月球计划是目前全球最庞大的航天订单。SpaceX作为“月球版星舰”的唯一承包商,必须先完成金主的KPI。拿住月球,就是拿住了持续的现金流。

星舰的“练兵场” 火星往返动辄数年,一旦出事根本救不回来。而月球距离地球仅3天路程,是测试星舰生命支持系统、轨道加油和资源开采的完美“新手村”。

太空资源的前哨站 月球南极的冰水物质,可以分解成氢和氧。这意味着月球将成为星舰前往深空的“太空加油站”。如果不能在月球站稳脚跟,火星殖民地只能是无米之炊。

三、 10年建城,是吹牛吗?
如果是别人说这话,大家会一笑了之。但说这话的是那个把“猎鹰”火箭像电梯一样回收、把全球最大卫星网布满轨道的马斯克。

马斯克的“建城”逻辑主要依靠两件大杀器:

恐怖的运力成本: 随着“星舰”迭代,单次发射成本有望降至千万美元级别。马斯克计划通过大规模机群,像“星链”一样往月球搬运物资。

3D打印与资源原位利用(ISRU): 未来的月球城不会从地球搬砖,而是利用月壤进行3D打印,建造防辐射的地下掩体和圆顶屋。

“在月球上建立一个永久性的人类存在,是通往火星最坚实的阶梯。” —— 马斯克

四、 结语:这不仅是马斯克的转向
马斯克的“改道”,实际上反映了人类航天思维的转型:从“插旗打卡”式探索,转向“可持续开发”式定居。

火星依然是终点,但月球已成为必经之路。10年后的月球地平线上,或许真的会亮起人类的第一盏长明灯。

发布
问题